در یک مطالعه جدید، محققان اپل یک مدل زبانی جدید از نوع دیفیوژن (Diffusion) ارائه کردهاند که قادر است متن را تا 128 برابر سریعتر از مدلهای همرده خود تولید کند. در ادامه نحوه عملکرد این مدل را بررسی میکنیم.
ویژگیهای مدل زبانی جدید اپل
برای درک این مطالعه، باید بدانید که مدلهای زبانی بزرگ مانند ChatGPT مدلهای خودبازگشتی هستند. این مدلها متن را به صورت ترتیبی و در هر مرحله یک توکن تولید میکنند و هنگام تولید هر توکن، هم متن ورودی کاربر و هم تمامی توکنهای تولید شده قبلی را در نظر میگیرند.
در مقابل، مدلهای دیفیوژن وجود دارند که توانایی تولید همزمان چندین توکن را دارند و در چندین مرحله تکراری آنها را اصلاح میکنند تا پاسخ نهایی شکل بگیرد. یکی از گونههای مدلهای دیفیوژن، مدلهای flow-matching هستند که عملاً فرآیند تکراری مدلهای Diffusion را دور میزنند و یاد میگیرند تا نتیجه نهایی را یکجا تولید کنند.
برای مطالعه عمیقتر درباره نحوه عملکرد مدلهای دیفیوژن، میتوانید پست اپل درباره مدل برنامهنویسی مبتنی بر Diffusion را بررسی کنید. و برای آشنایی بیشتر با مدلهای flow-matching، به پست اپل درباره مدل flow-matching برای تا شدن پروتئین مراجعه کنید.
در مطالعهای که امروز منتشر شده و عنوان آن “FS-DFM: Fast and Accurate Long Text Generation with Few-Step Diffusion Language Models” است، محققان اپل و دانشگاه ایالتی اوهایو مدلی جدید به نام Few-Step Discrete Flow-Matching یا FS-DFM معرفی کردهاند.
در این مطالعه، محققان نشان دادهاند که FS-DFM توانسته است متون بلند را تنها با هشت مرحله اصلاح سریع تولید کند، در حالی که کیفیت آن با مدلهای دیفیوژن که بیش از هزار مرحله نیاز داشتند برای رسیدن به نتیجه مشابه، برابری میکند.
برای رسیدن به این عملکرد، محققان از یک روش سه مرحلهای استفاده کردهاند: ابتدا مدل آموزش داده میشود تا با بودجههای مختلف از مراحل اصلاح کار کند، سپس از یک مدل راهنما استفاده میکنند تا در هر مرحله اصلاحات بزرگتر و دقیقتری بدون ایجاد اشتباهات متن تولید کند و در نهایت نحوه عملکرد هر مرحله اصلاح تغییر مییابد تا مدل بتواند در تعداد مراحل کمتر و با ثبات بیشتری به نتیجه نهایی برسد.
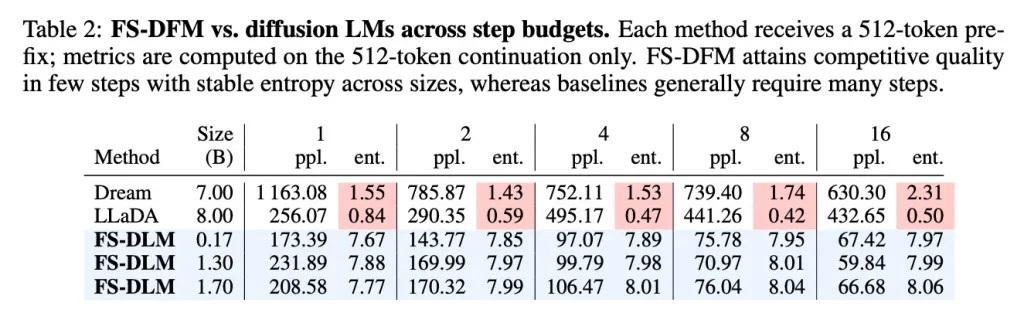
در مقایسه با مدلهای دیفیوژن بزرگتر، FS-DFM در دو بنچمارک مهم perplexity و entropy عملکرد خوبی نشان داده است. در یک نگاه کلی، بنچمارک perplexity معیاری استاندارد برای سنجش کیفیت متن در مدلهای زبانی است. هر چه perplexity کمتر باشد، متن دقیقتر و طبیعیتر به نظر میرسد.
از سوی دیگر، entropy به میزان اطمینان مدل در انتخاب هر کلمه اشاره دارد. اگر entropy بیش از حد پایین باشد، متن ممکن است تکراری یا قابل پیشبینی شود، و اگر خیلی بالا باشد، متن میتواند تصادفی یا غیرمنسجم به نظر برسد.
در مقایسه با مدل دیفیوژن Dream با 7 میلیارد پارامتر و مدل دیفیوژن LLaDA با 8 میلیارد پارامتر، مدلهای FS-DFM با 1.7، 1.3 و 0.17 میلیارد پارامتر به طور مداوم perplexity پایینتری داشته و entropy پایدارتر را در تمام مراحل حفظ کردهاند.
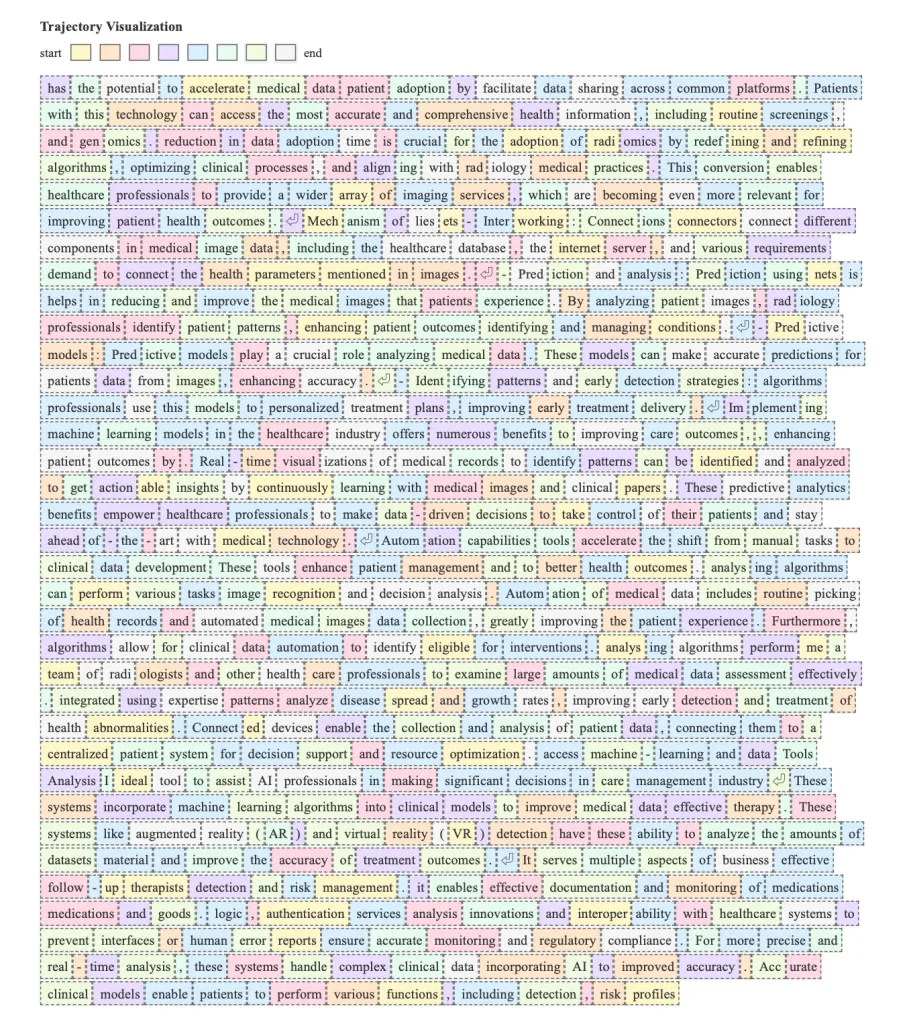
با توجه به کمبود مدلها و مطالعات مشابه، محققان اعلام کردهاند که «برنامه داریم کد و نقاط بازبینی مدل را منتشر کنیم تا امکان بازتولید و تحقیقات بیشتر فراهم شود». برای مطالعه عمیقتر درباره روشهای اپل و جزئیات اجرایی مدلهای اپل، میتوانید مقاله کامل را در arXiv بررسی کنید. این مقاله شامل نمونههای متعددی از عملکرد مدل است، از جمله نمونههایی که با رنگبندی نشان میدهد هر کلمه آخرین بار در کدام مرحله تغییر کرده است.









دیدگاه شما پس از بررسی توسط تحریریه منتشر خواهد شد. در صورتی که در بخش نظرات سوالی پرسیدهاید اگر ما دانش کافی از پاسخ آن داشتیم حتماً پاسخگوی شما خواهیم بود در غیر این صورت تنها به امید دریافت پاسخ مناسب از دیگران آن را منتشر خواهیم کرد.
ایمیل شما منتشر نخواهد شد.